Anything Ipsum
Du faux texte sur le thème de votre maquette, écrit par une IA et réglé pour rester du faux texte.
Le contexte
Le lorem ipsum a deux défauts quand on montre une maquette à un client. Le premier, c'est qu'il ne dit rien du résultat final : du faux latin n'a ni les mots ni le ton du contenu qui viendra à sa place. Le second est plus bête. Une fois sur deux, la réunion commence par « pourquoi c'est en latin ? ».
L'excès inverse ne vaut pas mieux. Si je rédige de vrais textes pour une maquette, j'y passe des heures, et le client se met à corriger les virgules au lieu de regarder la mise en page.
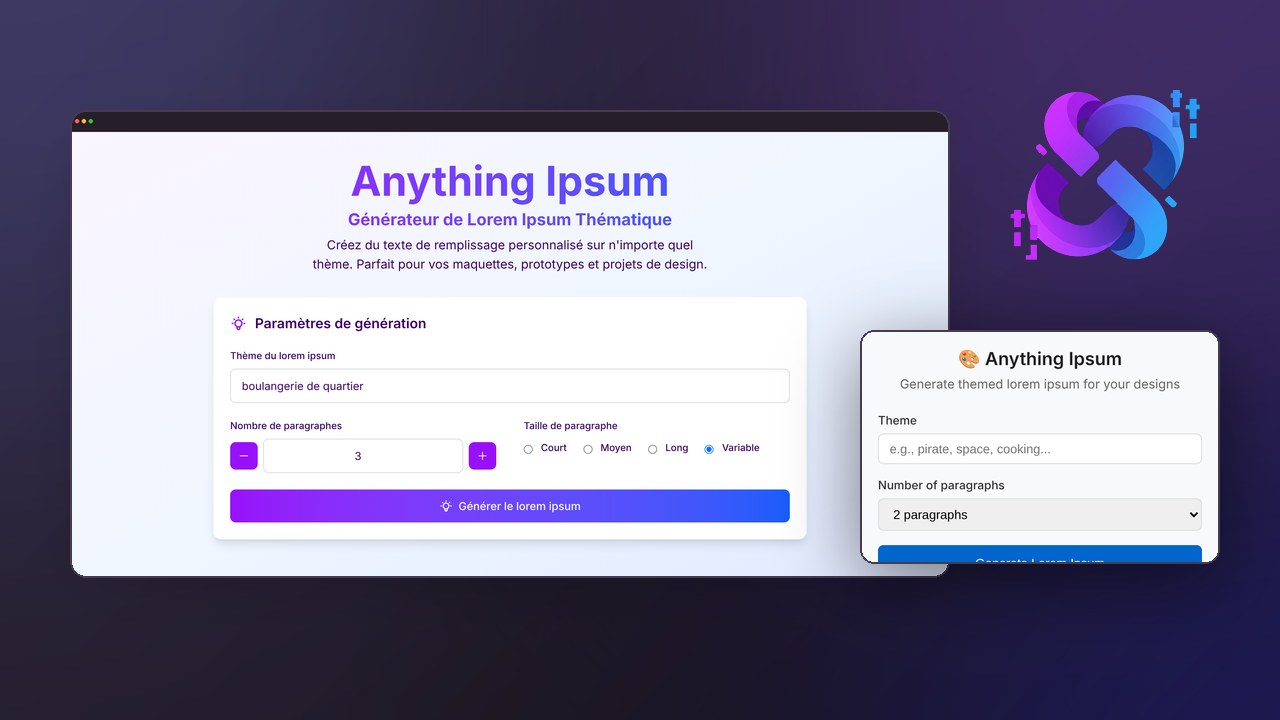
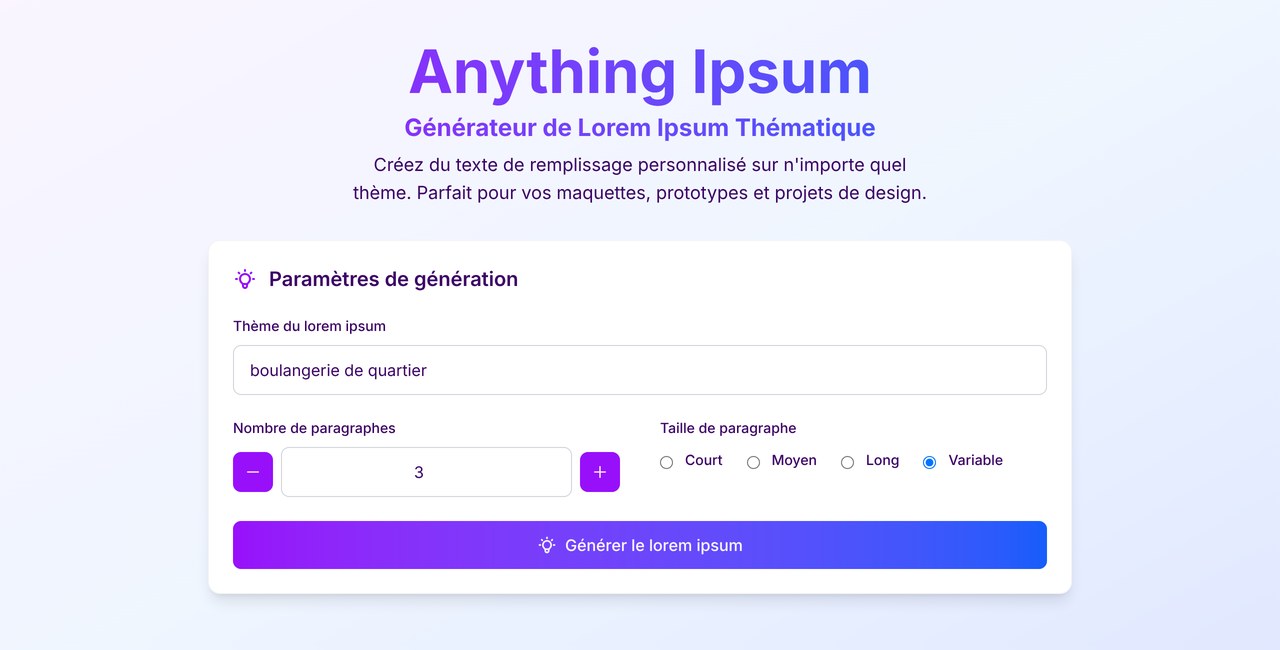
Anything Ipsum se place entre les deux. On tape un thème, on choisit le nombre de paragraphes et leur longueur, et un modèle de langage écrit du remplissage qui parle de boulangerie pour le site d'une boulangerie. Je l'ai codé un samedi, le 26 juillet 2025 : premier commit à 0 h 53, générateur fonctionnel à 15 h 41, version 1.0.0 à 21 h 13.
Du faux texte qui doit rester faux
C'est le point le moins évident du projet. Un modèle de langage veut bien faire. Demandez-lui un texte sur une boulangerie et il rend une page « Notre histoire » tout à fait crédible, avec un fondateur et un levain transmis de père en fils. Dans une maquette, c'est un piège, parce qu'un client pressé le prend pour le texte définitif et le valide.
La consigne envoyée au modèle lui demande donc l'inverse de ce qu'il fait d'habitude :
- Les phrases doivent avoir une structure similaire au lorem ipsum
  (un peu artificielle mais lisible)
- Mélange des mots du thème avec des mots de liaison classiques
- Le résultat doit être du texte de remplissage, pas du contenu informatif réel
Le texte obtenu a le vocabulaire du sujet et la silhouette d'un vrai contenu, mais il ne raconte rien. Personne ne le confond avec la version finale, et c'est ce qu'on lui demande.
Le modèle a quand même ses manies. La version 1.0.2 du 9 août corrige une seule chose : il glissait des astérisques de mise en gras au milieu des paragraphes, comme s'il rédigeait du Markdown. Le serveur les retire désormais au passage.
Le texte arrive pendant qu'il s'écrit
Dans la première version, on cliquait sur « Générer » puis on regardait tourner un indicateur de chargement jusqu'à ce que la réponse complète arrive. Sur trois longs paragraphes, l'attente se compte en secondes, et elles paraissent longues.
La 1.1.0 du 11 août 2025 affiche le texte au fil de l'eau. Le serveur demande la réponse en flux à Mistral, en extrait les morceaux de texte et les relaie tels quels au navigateur, qui les ajoute à l'écran dès qu'ils arrivent.
sequenceDiagram
    participant N as Navigateur
    participant S as Serveur (Express + Angular SSR)
    participant M as Mistral AI

    N->>S: POST /api/generate-lorem<br/>(thème, paragraphes, longueur)
    S->>M: Requête en mode flux
    M-->>S: Morceaux de texte
    S-->>N: Texte relayé au fur et à mesure
    N->>N: Affichage progressif
Le temps total est le même, mais on lit la première phrase presque tout de suite au lieu de fixer un écran vide.
Ce qu'il y a autour
L'API est ouverte : n'importe quel outil peut appeler POST /api/generate-lorem et récupérer son texte. Elle est limitée à 50 requêtes par quart d'heure et par adresse IP, pour que la facture du modèle reste la mienne sans devenir un problème.
Le déploiement tient en une commande. À chaque modification de la branche principale, GitHub Actions construit l'image Docker et la publie ; un docker compose up suffit ensuite pour la faire tourner n'importe où.
Le dépôt contient aussi un plugin Figma, parce que c'est dans Figma qu'on a besoin de faux texte. Il remplace le contenu du calque de texte sélectionné, ou en crée un nouveau. Son état réel : c'est un prototype, il parle encore à un serveur local et n'est pas publié dans la communauté Figma.
Ce que je ferais autrement
Je regarde ce projet avec un an de recul, et c'est l'interface qui me gêne le plus. Dégradé violet et cartes blanches : elle ressemble à la moitié des outils d'IA sortis en 2025. Elle fait le travail, mais elle n'a rien de moi.
Le choix du modèle se discute aussi. J'ai branché le plus gros modèle de Mistral et je l'ai écrit en dur dans le code. Pour produire du texte qui ne veut rien dire, un petit modèle rapide suffit largement, il coûte moins cher et consomme moins. Et un nom de modèle figé dans une image Docker, c'est un redéploiement obligatoire le jour où le fournisseur revoit ses offres.
Dernier raccourci visible, la longueur. La réponse est plafonnée à 1 000 tokens, soit quelques centaines de mots. Demandez dix longs paragraphes et le texte s'arrête au milieu d'une phrase.
Rien de tout ça n'est difficile à corriger. C'est ce qui reste d'un outil codé en un samedi quand on n'y est pas revenu depuis.
Stack technique
| Couche | Technologie | Ce qu'elle fait ici |
|---|---|---|
| Interface | Angular 20 (composants autonomes, signals) | Le formulaire et l'affichage du texte au fil de l'eau |
| Serveur | Express 5, intégré au rendu serveur d'Angular | Sert la page déjà construite et porte l'API |
| Génération | Mistral AI, mistral-large-latest |
Écrit le faux texte, en flux |
| Garde-fou | express-rate-limit | 50 requêtes par quart d'heure et par adresse IP |
| Style | Tailwind CSS 4 | Thème clair et thème sombre |
| Dépôt | Nx | L'application web et le plugin Figma au même endroit |
| Déploiement | Docker, GitHub Actions, GHCR | Image reconstruite et publiée à chaque modification |
Anything Ipsum est open source, sous licence MIT.